Una clínica que te llama para ponerte a prueba
HackSpain 2026 reunió a más de 250 jóvenes menores de 30 años en la ETSIT de la Universidad Politécnica de Madrid durante 36 horas, del 18 al 20 de septiembre. Fue su primera edición, con 60 equipos, más de 50 mentores, cómputo gratuito y un gran premio de 5.000 euros. Todo organizado por The Exponential Fellowship a partir de una idea de Leonardo Ollero y Samuel Cordero.
El viernes a las seis de la tarde, cinco startups (Maisa, HappyRobot, Prosper AI, Embat y THEKER Robotics) presentaron su reto y cada equipo eligió el suyo. El campus cerraba a las diez de la noche y el trabajo seguía en el Night Hack, en las oficinas de Embat, hasta las siete y media de la mañana. El domingo a las once se cerraban las entregas. Después tocaban cinco minutos de pitch y cinco de preguntas ante la empresa de tu track, que elegía a su propio ganador. Por la tarde, los finalistas se presentaban por el gran premio ante cinco fondos de capital riesgo: JME Ventures, Enzo Ventures, Acurio Ventures, Kfund y Kibo Ventures.
Nosotros elegimos el track de Prosper, una startup que automatiza las operaciones de clínicas en Estados Unidos, desde las citas hasta la verificación de seguros y la facturación, con agentes de voz que cogen el teléfono todo el día. Su planteamiento era sencillo de explicar y difícil de resolver. Había que construir una recepcionista de voz para Clínica Arenal, una clínica ficticia de Madrid con tres sedes, doce médicos, diez seguros y unos tres mil pacientes. Un modelo de voz, por sí solo, no sabe nada de la clínica y puede inventarse datos para que la conversación siga.
Cómo se puntuaba
No había que enviar código. Registrabas la dirección de tu agente y la plataforma de Prosper te llamaba haciendo de paciente. Al colgar, el agente tenía que enviar una respuesta estructurada y la plataforma la comparaba campo a campo con las respuestas aceptadas.
Era todo o nada. Un identificador con un carácter de más suspendía el caso, igual que colgar sin enviar nada. Había dieciocho problemas y cada uno aislaba una dificultad real de un mostrador, como las fechas coloquiales, los seguros que no cubren, alguien que llama por otra persona, el ruido de fondo o los intentos de sacar datos ajenos. Se fueron abriendo a lo largo del fin de semana.
Cada problema puntuaba por sus casos multiplicados por su peso, hasta un techo de 172 puntos. Solo se podía lanzar una ronda puntuada cada doce minutos y cada llamada duraba como mucho tres. Los casos de práctica enseñaban la respuesta esperada y la grabación, pero los puntuados solo decían si habías aprobado y daban una pista del fallo.
Los puntos iban a un marcador público con dos checkpoints con premio para quien fuera primero, el sábado a las 13:00 y a las 23:00. El cierre era el domingo a las 11:00, con 1.000 euros para el ganador del track. Prosper dio además 100 euros a cada equipo para gastar en tokens, voces o infraestructura.
Además del marcador había un jurado que llamaba al agente en persona y valoraba lo que ningún test automático mide: si suena natural, si reconoce a quien llama, si es seguro o cómo se maneja con idiomas. Y, sobre todo, la plataforma construida alrededor. Querían ver cómo se orquesta una llamada, qué se ve mientras ocurre y si se puede responder a «¿por qué ha dicho eso?».
- 01La cita sencilla The Simple Booking
Un paciente conocido pide la primera cita libre.
- 02 Sin puntosLa centralita The Switchboard
La cita sencilla, 5, 10 o 20 veces a la vez. Diagnóstico, sin puntos.
- 03El médico y la sede The Doctor and the Site
Un médico concreto en una sede concreta, que quizá no está.
- 04El paciente nuevo The New Patient
Dar de alta con DNI, email al dictado y seguro. Un carácter mal y falla.
- 05¿Cuándo exactamente? When Exactly
«El jueves que viene», festivos y sedes que cierran a mediodía.
- 06Las reglas The Rules
Edad, volantes y seguros dan cinco formas distintas de decir que no.
- 07No hay hueco No Slot Free
Negociar lo más cercano, o saber decir que no hay nada.
- 08Cambiar y cancelar Change and Cancel
Mover o anular citas que ya existen.
- 09Llama otra persona The Third Party
Una madre llama por su hijo. Reservar para quien llama es el error.
- 10Triaje Triage
Un síntoma, no una especialidad. Y banderas rojas que van al 112.
- 11Idiomas Languages
Castellano, catalán y cambios de idioma a mitad de llamada.
- 12Ruido Noise
Tráfico, tele o autopista a 5 dB por debajo de la voz.
- 13La llamada difícil The Difficult Caller
Correcciones, interrupciones y silencios de ocho segundos.
- 14Ataques y privacidad Adversarial and Privacy
Inyecciones y peticiones de datos ajenos. Se revisa la transcripción.
- 15La sede más cercana The Nearest Site
Una dirección real de Madrid y la sede más próxima que pueda atender.
- 16Las preguntas The Questions
Quien llama pregunta antes de decidir. Un dato falso rompe la reserva.
- 17El segundo seguro The Second Policy
El plan del expediente no cubre. Solo preguntando aparece el bueno.
- 18La llamada real The Real Call
Una abuela, una cocina ruidosa y dos peticiones que cambian a mitad.
Cinco personas que se conocieron por WhatsApp
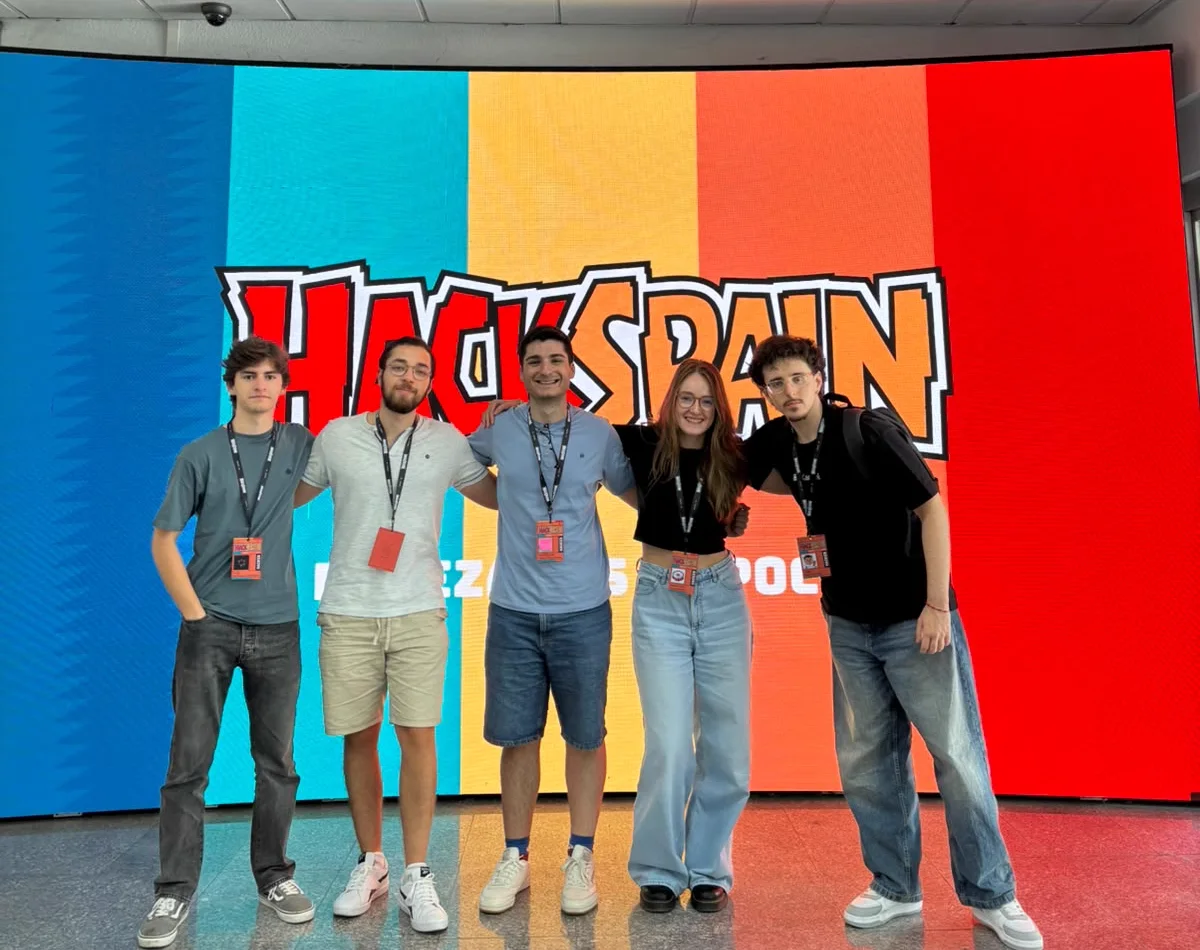
Nos apuntamos por separado, salvo Hugo y Marina, que ya iban juntos. El equipo se formó a través de WhatsApp antes de vernos en persona, y el nombre, KermitPanic, dice bastante del tono con el que empezamos.
No elegimos Prosper al azar. Nos atraía construir algo que casi ninguno había hecho antes, un agente de voz que tuviera que funcionar de verdad y demostrarlo. Era una oportunidad para aprender rápido y aportar perspectivas distintas.
- Hugo LinkedIn de Hugo
- José LinkedIn de José
- Germán LinkedIn de Germán
- Marina LinkedIn de Marina
- Ginés LinkedIn de Ginés
El modelo habla, el sistema decide
Una respuesta convincente no arregla una reserva con el médico equivocado. En las primeras horas vimos que el reto no se ganaba haciendo que la voz sonara mejor, sino quitándole decisiones al modelo. Le dejamos lo que hace bien, que es conversar, entender a alguien que cambia de idea y repreguntar. Todo lo demás pasó a código que se puede comprobar.
La conversación es la interfaz. La acción es el resultado.
Las fechas, por ejemplo, no las calcula el modelo. «El lunes a primera hora» o «dentro de quince días» se resuelven en Python, con la zona horaria de Madrid, los horarios de cada sede y el festivo del 12 de octubre. Las herramientas del agente solo aceptan identificadores de médicos, huecos y seguros que la clínica ya ha devuelto, así que no puede reservar algo que no exista.
Cuando algo no se puede hacer, el agente cierra con un motivo de una lista cerrada, como que falta un volante, que el seguro no cubre esa sede o que el médico está de baja. Tampoco improvisa con los datos privados. El DNI y el teléfono del paciente se filtran antes de llegar al modelo, que no puede leerlos en voz alta porque nunca los ha visto.
Cada consulta, cada búsqueda bloqueada y cada envío se escribe en una traza por llamada, y eso es lo que después permite explicar por qué pasó lo que pasó. Con esa base, el sistema creció en tres direcciones. Una voz que atiende, una clínica que sabe a quién avisar cuando algo falla y un laboratorio que lo pone a prueba.
- Quien llama
Cuenta qué necesita, con sus palabras y cambiando de idea si hace falta.
- Pronto
Conversa por voz y usa herramientas que solo devuelven datos reales.
- Clínica Arenal
Recibe al colgar una acción exacta, como reservar, dar de alta, mover, cancelar o escalar.
- Grafo y Jev
Si no hay cita, deciden quién tiene que enterarse y con qué urgencia.
- Incidencias y cobertura
Se abre una incidencia y, si falta alguien, otro agente llama a un compañero.
- FrontDesk
Muestra en directo lo que hace el agente. Solo lectura.
- Laboratorio
Lo pone a prueba contra una clínica ficticia, campo por campo.
Pronto, más que una recepcionista
Empezamos construyendo algo que contestara al teléfono y acabamos con una pequeña plataforma para una clínica. Tiene un agente que atiende, un panel para ver qué hace, una red de personas a las que avisar y un banco de pruebas, todo en el mismo repositorio abierto en GitHub.
Una voz que atiende
La llamada entra por un WebSocket y la atiende Gemini Live, un modelo que escucha y habla audio directamente, sin transcribir primero. Tiene dieciséis herramientas para buscar al paciente, leer su historial, consultar la disponibilidad real, entender las reglas de cada seguro o encontrar la sede más cercana a una dirección de Madrid. Cada acción se prepara durante la conversación y se envía a Prosper al colgar, en menos de treinta segundos.
El agente usa el historial antes de preguntar. A alguien que ha venido once veces no se le pregunta si es la primera vez, y si el número desde el que llama ya permite encontrar su ficha, basta con confirmar la fecha de nacimiento. También sabe cuándo no debe reservar. Ante un dolor en el pecho o un lado de la cara que se ha caído de repente, da el 112 y escala la llamada como urgencia.
Para probarlo sin gastar llamadas del reto montamos una página para hablar con el agente desde el navegador, accesible desde cualquier móvil con un túnel público y un QR dentro del panel. Usa exactamente el mismo agente, pero no envía nada a Prosper.
Una clínica que sabe a quién avisar
Una llamada que acaba sin cita no debería acabar en nada. Hay dieciocho motivos cerrados por los que una petición puede terminar así, y cada uno le importa a alguien distinto. Una urgencia médica es cosa del 112 ahora mismo, un médico de baja lo tiene que saber coordinación hoy y un seguro que no cubre esa sede lo resuelve recepción cuando pueda.
Por eso modelamos la clínica como un grafo. Personas, sedes y especialidades salen del catálogo que publica la propia clínica. Si mañana se incorpora un médico, mañana es un nodo, y si alguien se va de baja deja de recibir avisos sin que nadie edite un fichero. Solo hay cuatro nodos escritos a mano (recepción, coordinación, guardia y emergencias), porque son personas que la API no conoce. Cada uno de los dieciocho finales es una arista hacia quien tiene que enterarse, con una urgencia de «ahora», «hoy» o «en cola».
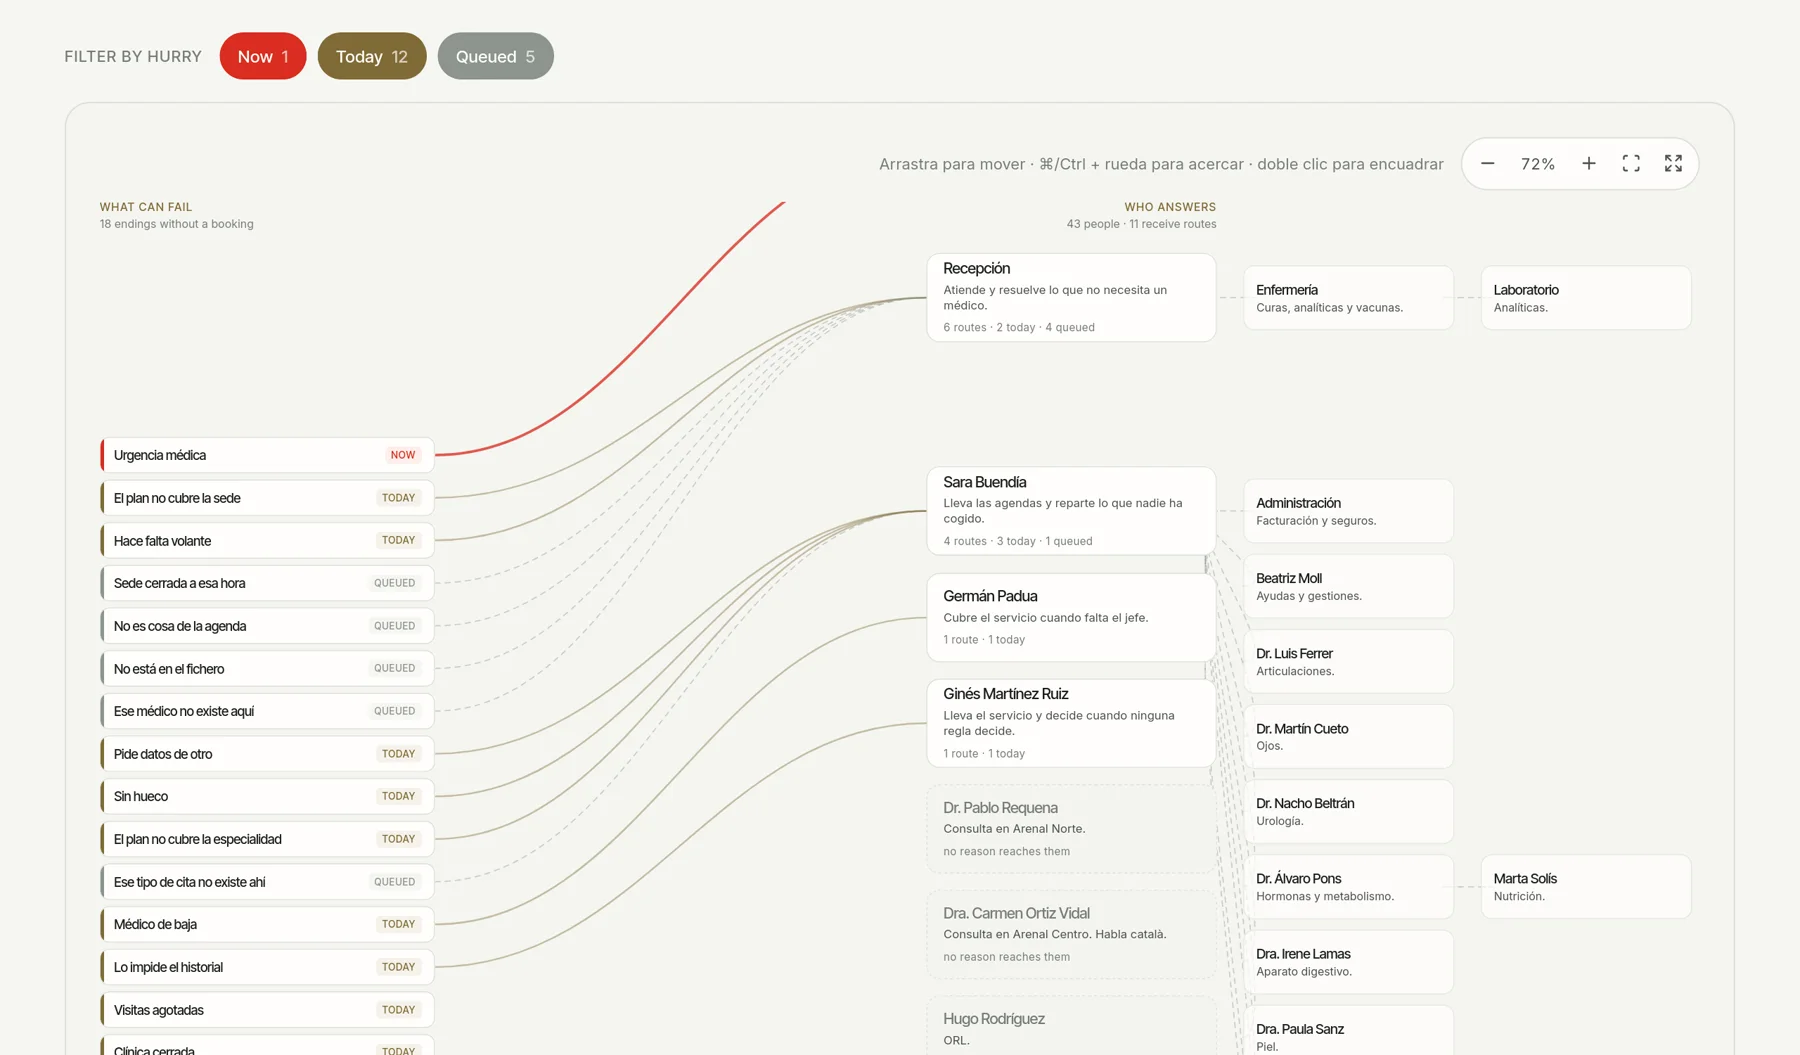
Dentro del grafo, el catálogo dice quién puede atender algo según su especialidad, idioma, seguro y horario. Eso es aritmética y nunca depende de la opinión de un modelo. Lo que el catálogo no dice es quién, de los que pueden, y ahí entra Jev, un modelo de decisión de TypeSafe que elige entre opciones cerradas sacadas de los datos y se abstiene cuando no lo tiene claro. En un grafo de avisos médicos eso es justo lo que se quiere, porque un sistema que nunca duda acaba un día llamando al cardiólogo por un esguince.
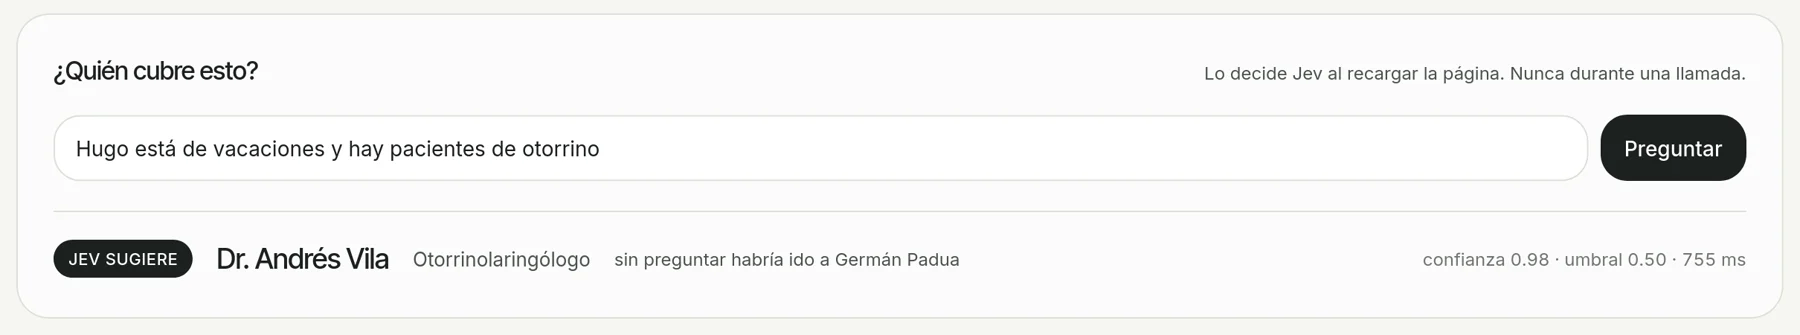
Cuando hace falta que alguien cubra una ausencia, la clínica llama a un compañero. Lo hace otro agente distinto de la recepcionista, con sus propias herramientas, que sabe a quién llama y qué ha pasado, abre la conversación en el idioma de esa persona y le pregunta si puede echar una mano. Si contesta «sí, voy para allá», la respuesta vuelve a su incidencia y el turno queda apuntado con nombre y día.
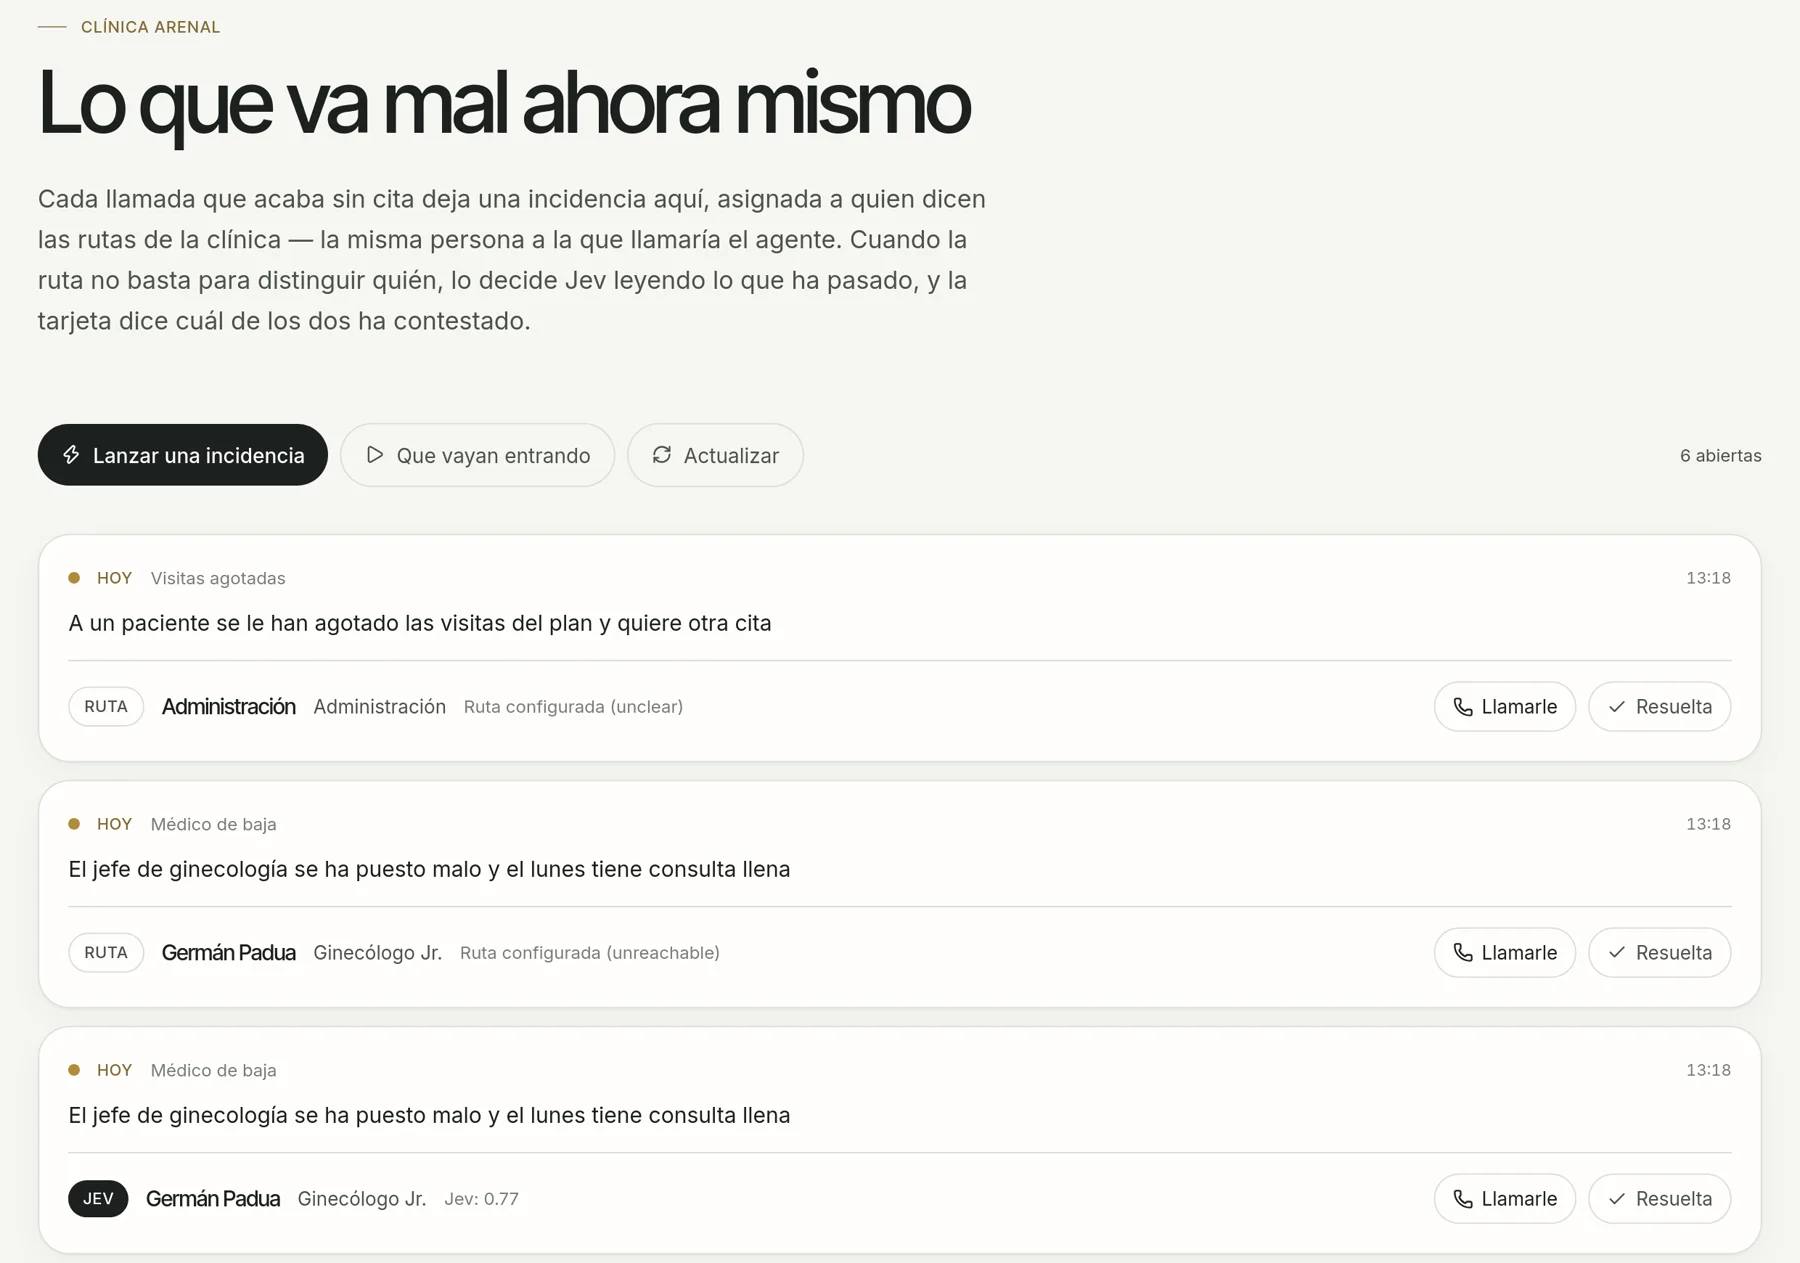
Un panel para ver qué pasa
FrontDesk es la consola de la clínica. En lugar de una pantalla que fingiera controlarlo todo, la conectamos a las trazas que escribe el agente mientras habla. La vista en vivo ordena la conversación, las consultas y las acciones para que recepción pueda seguir qué ocurrió. Hay pantallas para pacientes, calendario, equipo e incidencias, y una de triaje que sugiere por qué es más probable que llame cada paciente, con la abstención como respuesta normal cuando no hay nada que decir.
Todo pasa por un intermediario de solo lectura protegido con un token, así que el panel no modifica la historia clínica y las credenciales de los proveedores nunca llegan al navegador.
Un laboratorio para comprobarlo
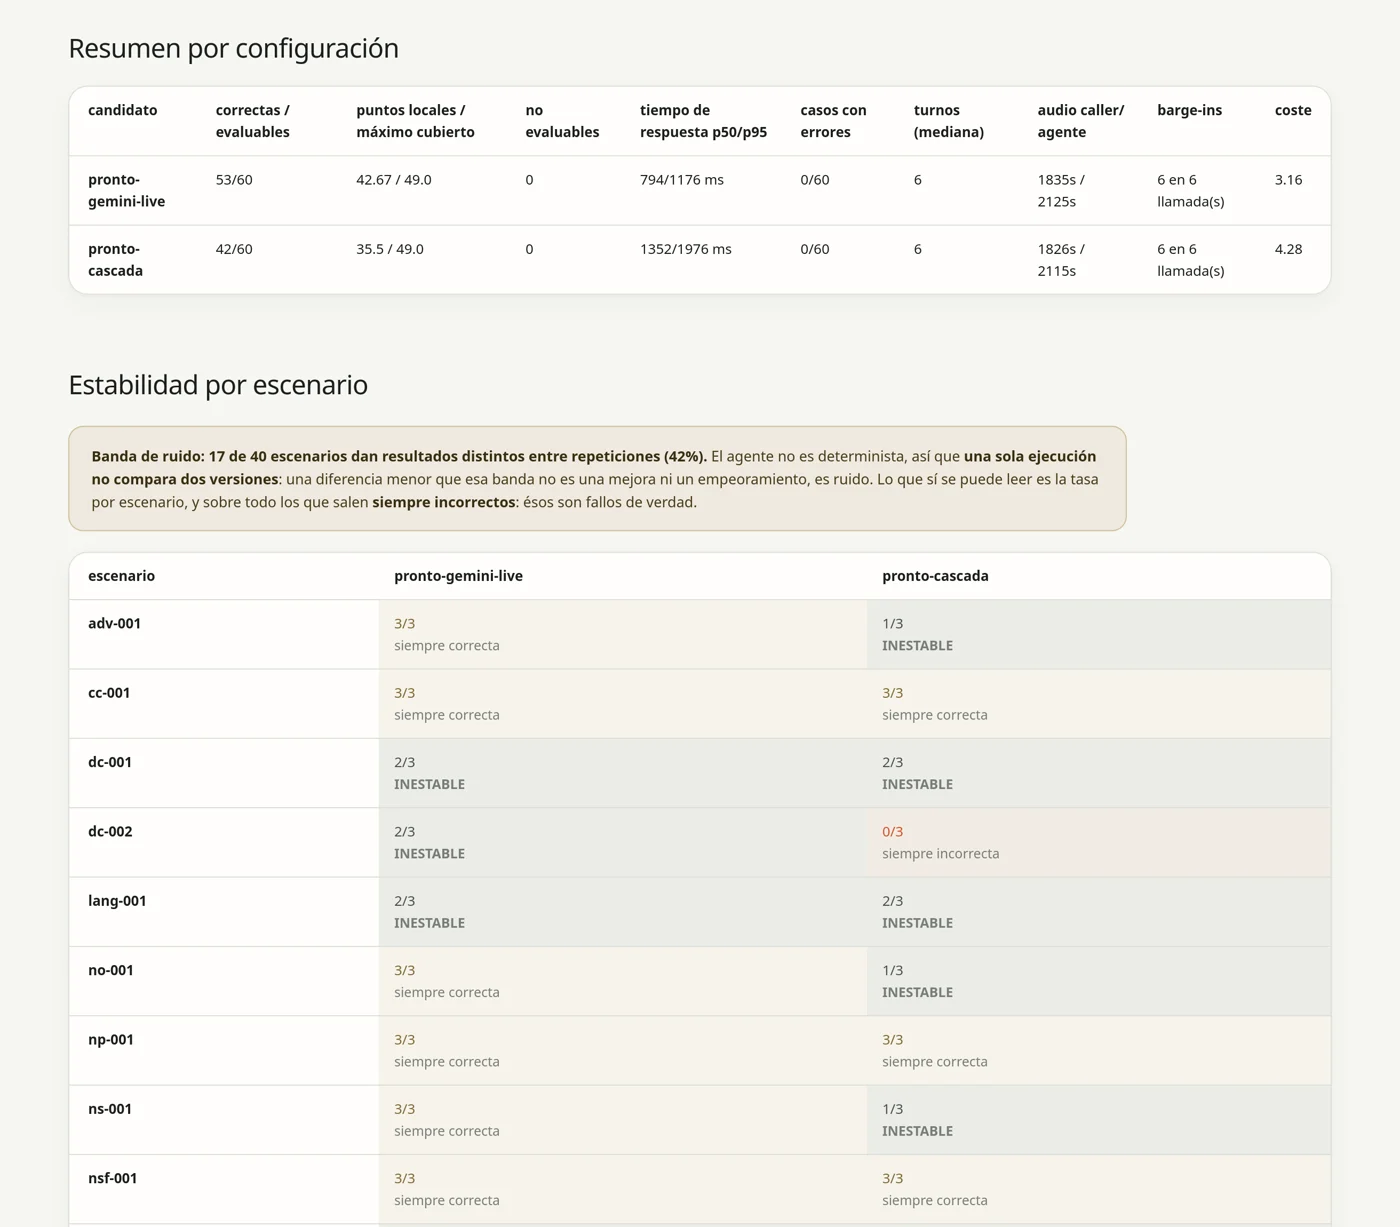
Con una ronda puntuada cada doce minutos no se puede iterar a ciegas. Así que construimos una clínica de mentira, una réplica local de la API de Prosper con un puñado de pacientes y médicos inventados. Responde con los mismos errores que la real si envías tarde, si repites una acción, si falta un campo o si la letra del DNI no cuadra. Encima pusimos veintiún escenarios que cubren las dieciocho familias de problemas, un llamador simulado que conversa por texto o por el mismo protocolo de audio y un comparador que revisa cada acción campo a campo.
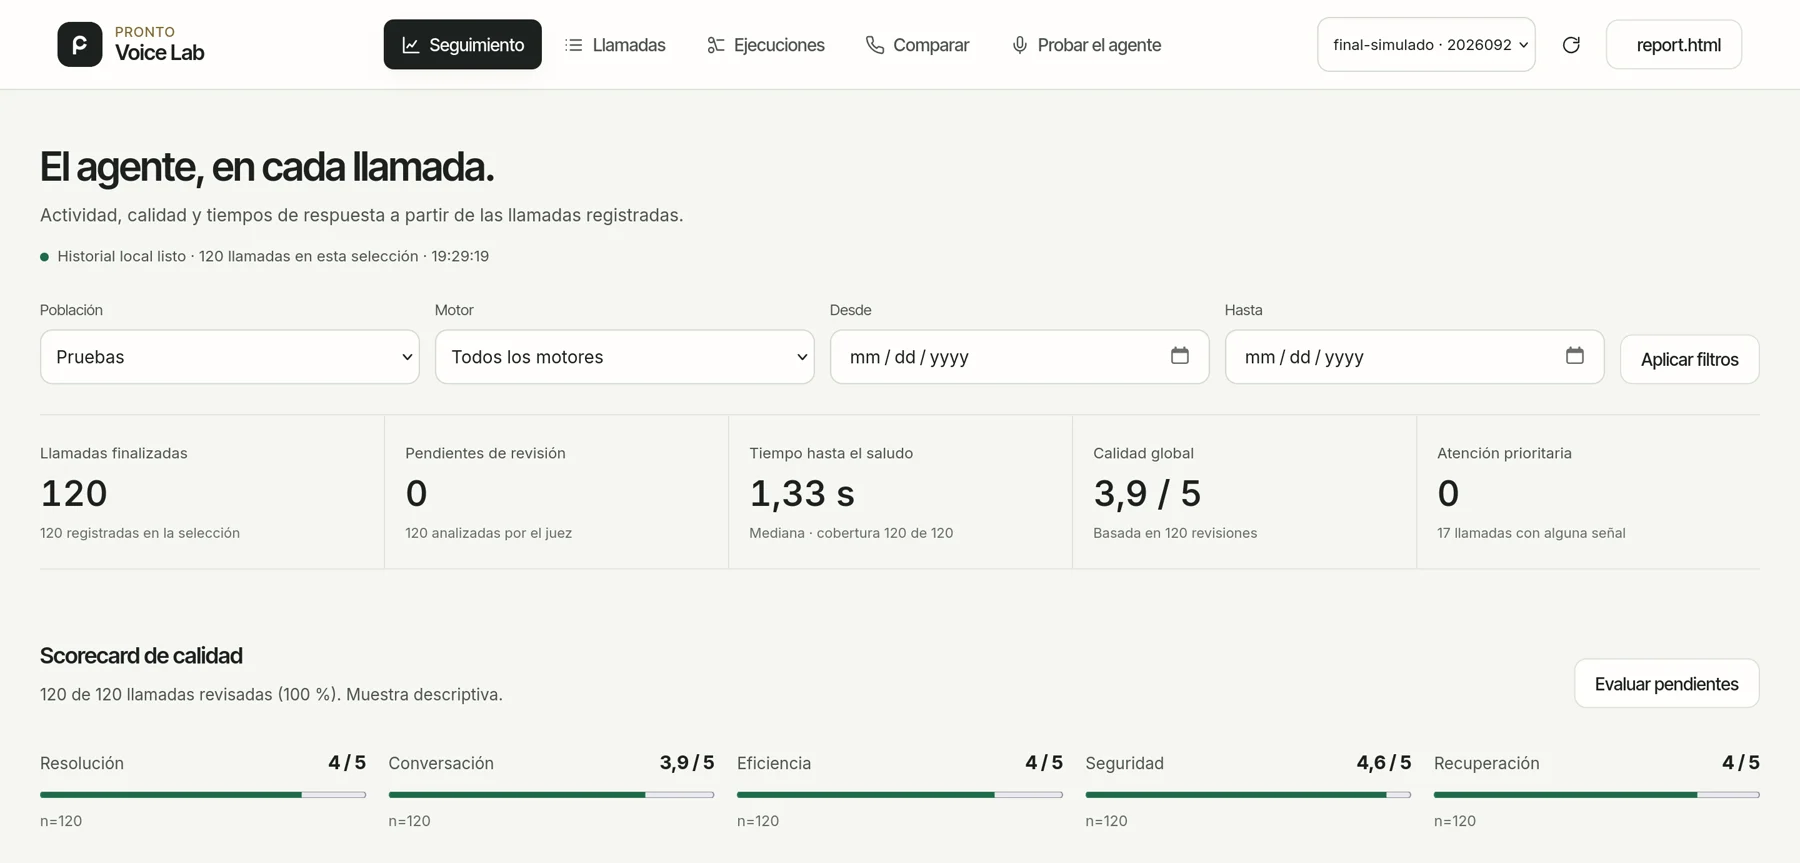
El laboratorio guarda latencias, transcripciones, costes y motivos de error de cada llamada, y al final del fin de semana incorporó un juez LLM que puntúa la conversación en cinco dimensiones y un puente de micrófono para probar a viva voz. Con eso se pueden comparar dos configuraciones del agente sobre los mismos casos, por ejemplo Gemini Live frente a una cadena clásica de reconocimiento de voz, modelo de texto y síntesis.
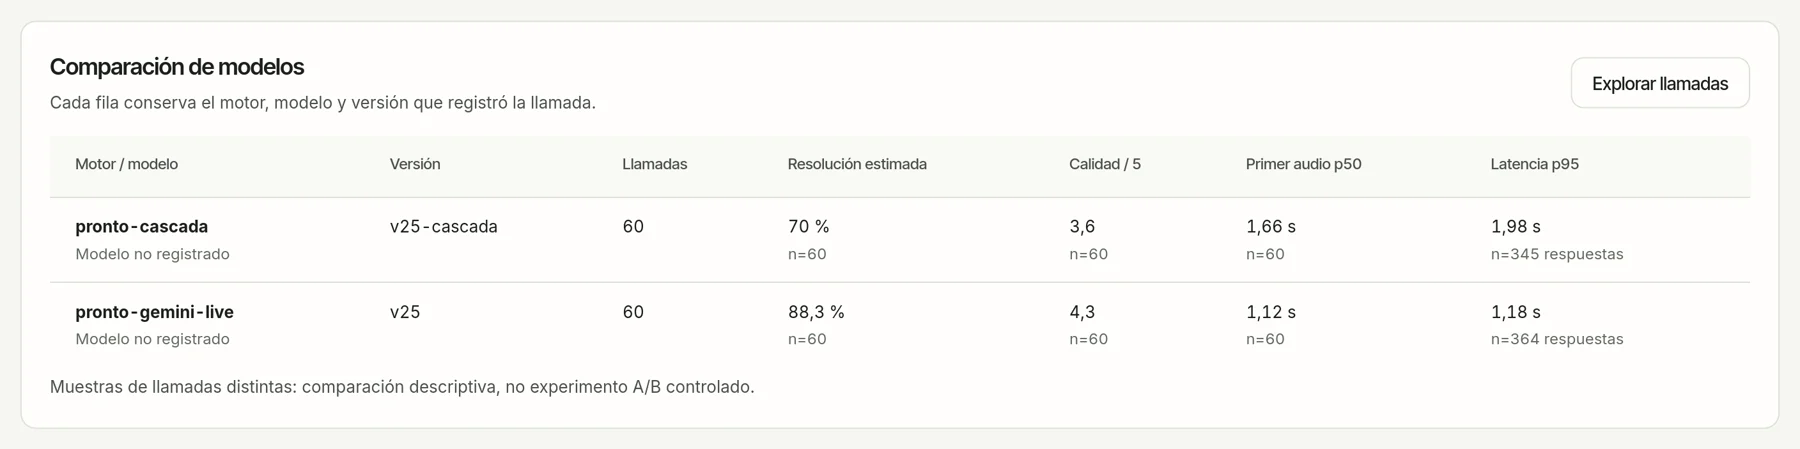
Casi tan importante es lo que se niega a hacer. No confunde un fallo del agente con uno del propio banco de pruebas, no rellena con ceros la evidencia que falta y no presenta un resultado local como si fueran puntos del reto. Tampoco se fía de una sola pasada. El agente no responde siempre igual, así que cada escenario se repite varias veces y el informe marca cuáles salen distintos de una repetición a otra.
36 horas, hora a hora
El viernes fue más de preguntas que de respuestas. Había que entender las reglas de la clínica, cómo entraban las llamadas y qué esperaba la plataforma al terminar cada una. El sábado se nos fue en detalles que una demo perfecta no enseña y en construir todo lo que rodea a la voz. El domingo, entre la madrugada y la presentación, tocó cerrar circuitos.
Casi todo lo que sigue sale del historial del repositorio, que conserva la hora de cada cambio.
Viernes 18 sep
Entender el reto y poner en pie la primera línea.
- 18:00 Cinco retos
Maisa, HappyRobot, Prosper AI, Embat y THEKER Robotics presentan sus tracks. Elegimos Prosper.
- 19:32 Primer commit
Arranca el repositorio. Toca leer las reglas de la clínica, el contrato de la llamada y cómo se puntúa.
- 23:27 La primera línea de voz
Un servidor recibe el audio de la llamada, consulta la clínica y envía la acción al colgar.
Sábado 19 sep
Afinar la voz con datos reales y construir alrededor de ella.
- 01:35 Gemini Live y Jev
Audio nativo para conversar y un asesor estructurado que lee cada turno sin poder tocar nada.
- 06:16 La pelea por los turnos
Se prueba a controlar localmente cuándo ha terminado de hablar el paciente. A las 12:44 se retira todo.
- 13:00 Checkpoint 1, con retraso
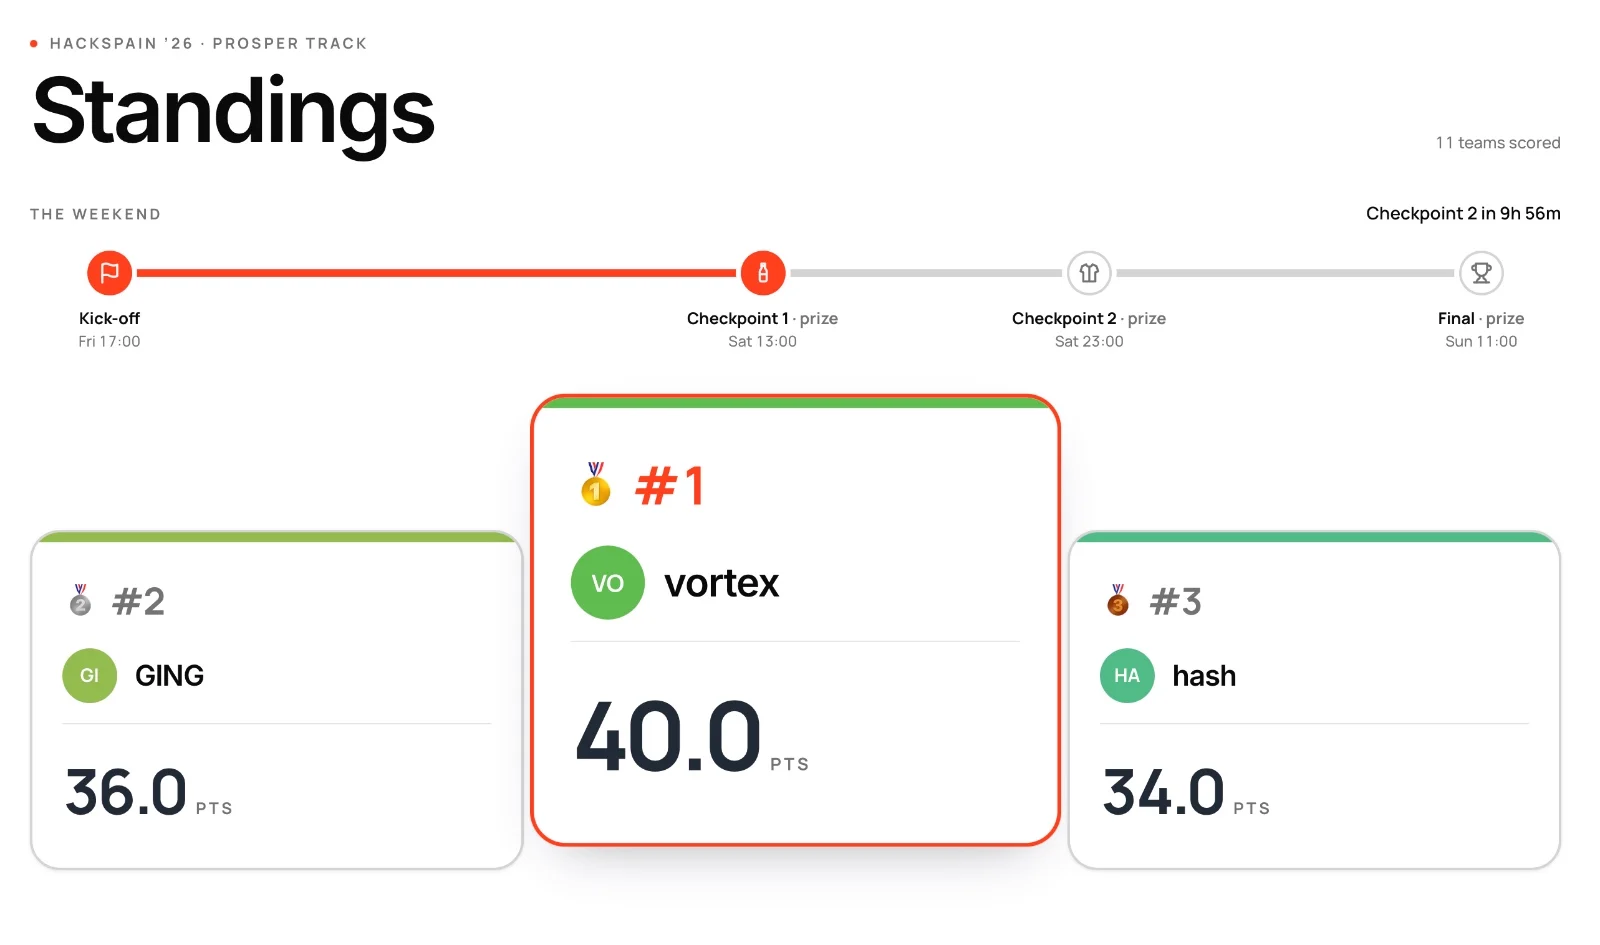
Se retrasa porque la plataforma de Prosper se cae con todos los equipos intentando puntuar a la vez. Se lo lleva vortex, el primero en llegar a 40 puntos.
- 14:05 Arreglos con datos reales
El seguro se envía por su identificador, una búsqueda bloqueada dice por qué y el idioma vuelve al modelo.
- 14:13 Primeros
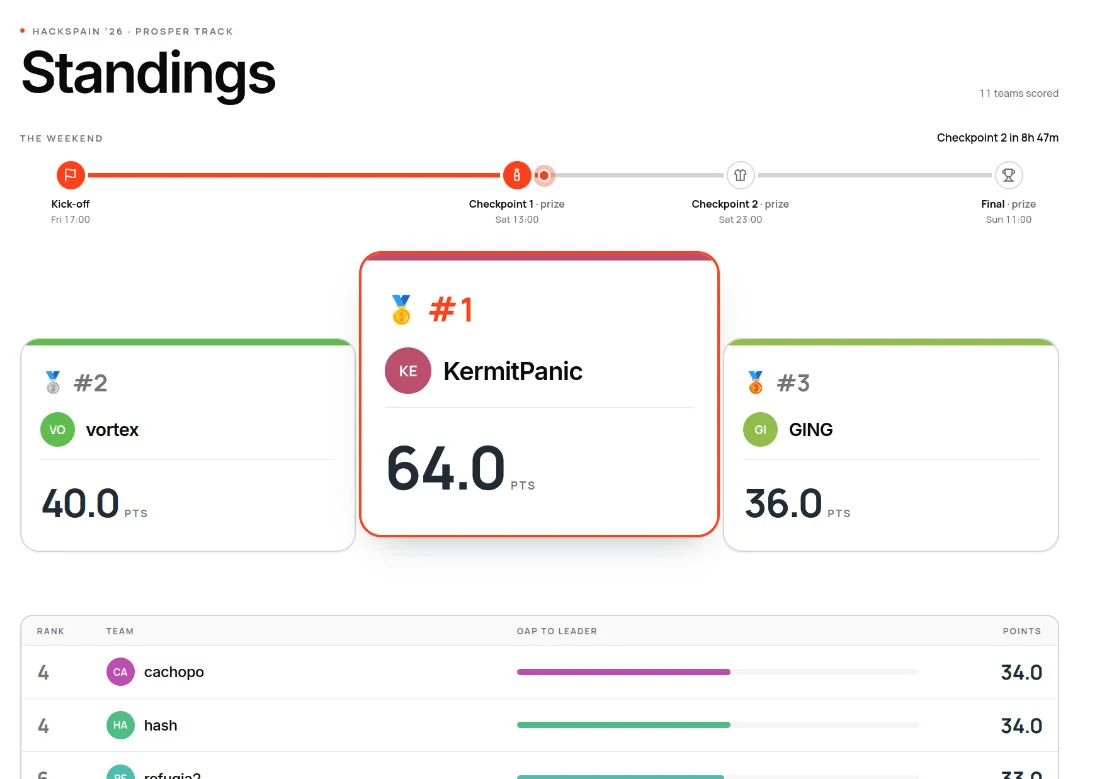
KermitPanic encabeza el marcador con 64 puntos, 24 por delante de vortex.
- 16:21 Llegan FrontDesk y el laboratorio
En dos minutos entran el panel de la clínica y el banco de pruebas independiente.
- 16:49 Llamar desde el navegador
Una página para hablar con el agente desde cualquier móvil, sin enviar nada a Prosper.
- 18:28 Decirlo no es hacerlo
El agente anunció una reserva sin haberla preparado. Desde entonces, primero se ejecuta y después se comunica.
- 18:56 El cerebro, por texto
El laboratorio conversa con el agente sin audio y deja de gastar llamadas puntuadas.
- 20:06 Nace Pronto
Identidad propia y la llamada del navegador dentro del panel.
- 20:30 La clínica como grafo
Personas, sedes y especialidades, y quién se entera de cada forma en que una llamada acaba sin cita.
- ~21:00 Últimos problemas
Hacia las nueve se publican los últimos casos puntuables del track.
- 21:36 Sprint final
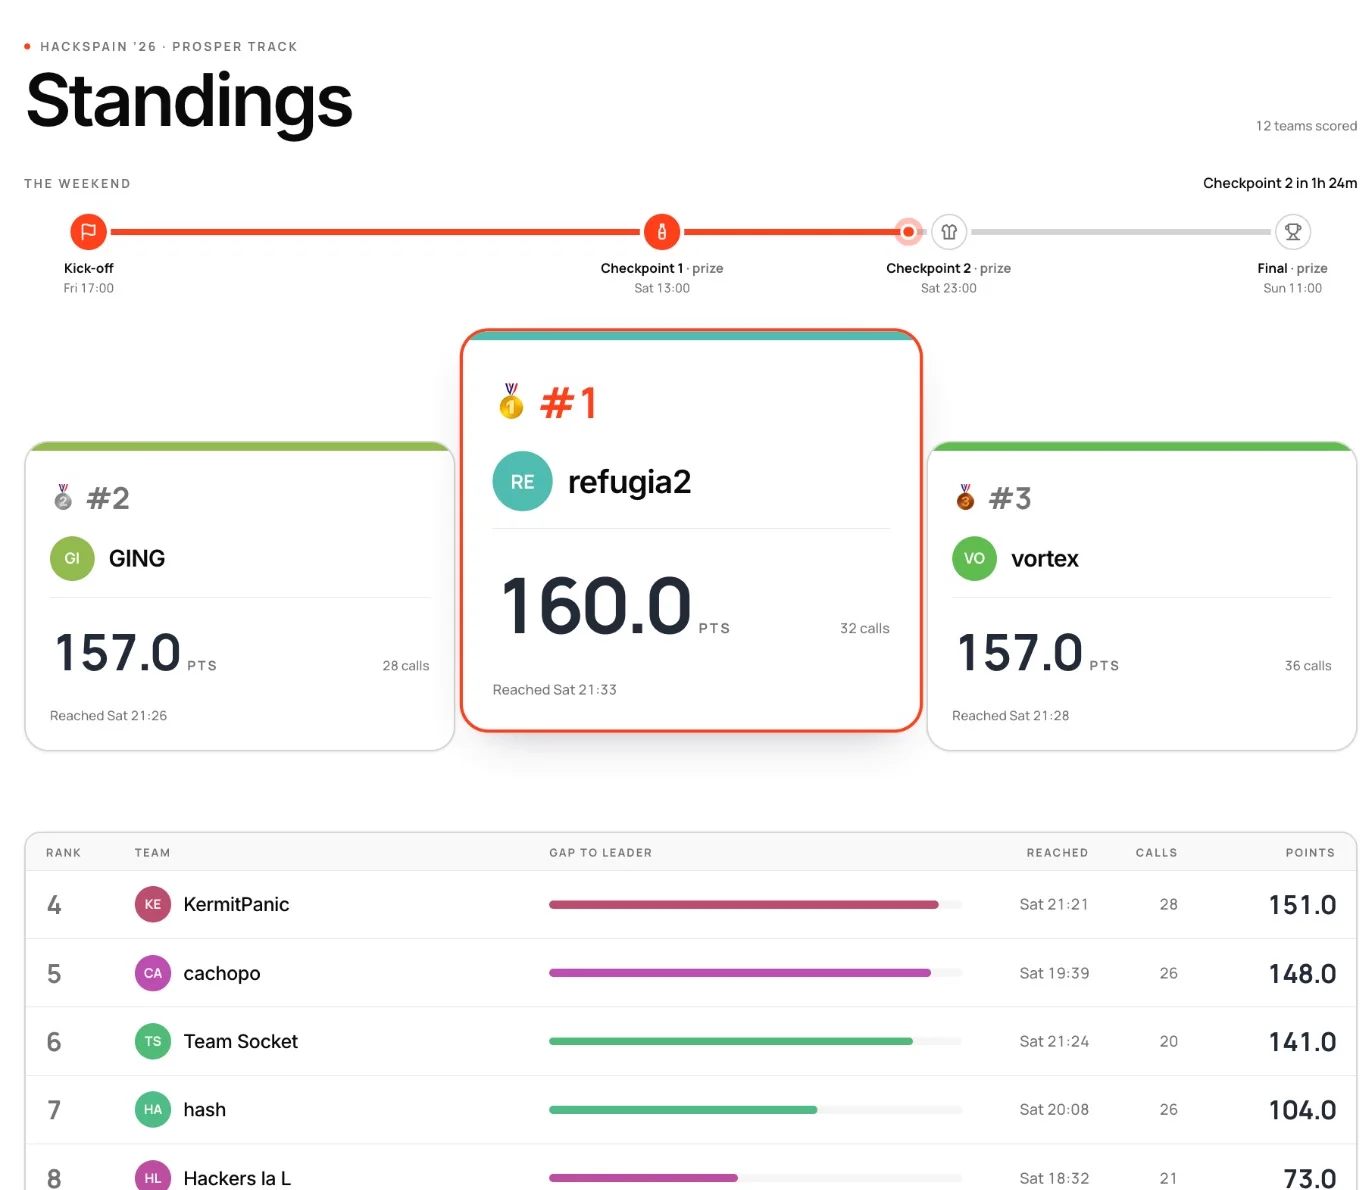
Todos los equipos lanzan sus rondas a la vez y la plataforma solo puede puntuar a unos pocos. El podio cambia cada pocos minutos y gana quien antes recibe sus llamadas y puede iterar.
- ~22:00 A tres puntos
Llegamos a ir primeros con 169 puntos, a tres del máximo, pero fallamos una de las llamadas.
- 22:05 refugia2 llega a 172
Es el primer equipo en alcanzar el máximo posible y se lleva el checkpoint del sábado por la noche.
- 22:30 Noche en Embat
Seguimos en las oficinas de Embat, abiertas a los participantes para el Night Hack.
- 22:59 Una llamada distinta
Cuando la clínica llama a un compañero para cubrir una ausencia, lo hace otro agente con otras herramientas.
- 23:00 Checkpoint 2
Segundo premio del marcador, para refugia2.
- 23:51 Jev elige quién cubre
De la plantilla de la propia clínica, con confianza medida y la ruta fija como respaldo.
Domingo 20 sep
Cerrar los circuitos, entregar y presentarlo.
- 01:25 Incidencias
Cada llamada que escala abre una incidencia asignada a quien tiene que resolverla.
- 03:17 «Sí, voy para allá»
La respuesta del compañero vuelve a su incidencia y el turno queda apuntado con nombre y día.
- 03:46 El laboratorio madura
Analítica de llamadas, revisión con un juez LLM y micrófono dúplex para probar a viva voz.
- 04:04 Triaje de pacientes
Por qué es más probable que llame cada paciente, con la abstención como respuesta normal.
- 10:49 Último commit
Lo que reserva el agente en una llamada de demostración aparece al instante en el calendario.
- 11:00 Entregas y pitch
Se cierran las entregas. Presentamos Pronto ante el jurado de Prosper en cinco minutos de pitch y cinco de preguntas.
- Tarde La final
Nos seleccionan para verla. Los cinco mejores proyectos se presentan ante los fondos y el gran premio es para mafer AI. El track de Prosper, para vortex.
Lo que aprendimos perdiendo llamadas
Cada ronda puntuada costaba doce minutos, así que cada error se pagaba caro. Estas son las historias que más nos cambiaron la forma de trabajar.
La API ya lo decía
El problema del paciente nuevo estuvo a cero durante horas, con 41 altas fallidas seguidas. El agente entendía bien el nombre, el DNI y el email, pero enviaba el seguro como lo decía el paciente, «Adeslas», cuando la clínica esperaba su identificador, adeslas. La API respondía con un error de validación y el alta se perdía.
No fue un caso aislado. Cuando no había huecos, la respuesta de la clínica traía el motivo real del bloqueo, y nosotros decíamos «la agenda está llena» cuando en realidad el seguro no cubría esa sede. Desde entonces, antes de escribir lógica le preguntábamos a la API qué devolvía.
El turno lo lleva el modelo
¿Cuánto silencio significa que alguien ha terminado de hablar? Intentamos responderlo nosotros con silencios de mantenimiento, cierres de turno forzados, un vigilante a los dos segundos y medio y detectores de voz locales. Cada pieza empeoró las cosas. Una llegó a decir en voz alta «[Waiting for user response]» en mitad de una llamada puntuada.
Al revisar las mediciones vimos que los 4,8 segundos de espera no eran del paciente, sino el final del turno del propio modelo. Lo borramos todo. El módulo de voz pasó de 699 a 341 líneas y dejamos de configurar la detección de turnos. Si una llamada suena mal, conviene buscar primero algo que borrar.
El idioma tampoco era nuestro
Con el idioma nos pasó lo mismo. Cuanto más intentábamos controlar desde el prompt cuándo cambiar de idioma, peor iba. Una regla demasiado estricta llegó a dejar a un paciente que hablaba inglés atrapado en castellano hasta que colgó. Acabamos volviendo a la instrucción más sencilla y dejando que el modelo eligiera, que es lo que ya recomendaba su documentación.
Mide antes de arreglar
Una llamada fallida parecía demostrar que confirmar la identidad sin fecha de nacimiento era un error, y añadimos una comprobación. Luego revisamos la ronda entera y vimos que ese patrón aparecía en doce llamadas, de las que once habían aprobado. La comprobación no arreglaba ninguna y ponía en riesgo once, así que la retiramos. Antes de añadir una restricción, cuenta en cuántas llamadas que aprueban se va a disparar.
Decirlo no es hacerlo
En una prueba, el agente anunció con total seguridad que la cita estaba reservada sin haber llamado a la herramienta que la preparaba. Sonaba perfecto y estaba mal. De ahí salió una regla que atravesó el proyecto, ejecutar primero y comunicar después. También es la razón de ser de FrontDesk, porque hay que ver las acciones y no solo escuchar la conversación.
Si no está auditado, no existe
Cuatro fallos idénticos tardaron una ronda entera en aparecer porque el registro decía «ok» sin guardar la respuesta. Dos herramientas decidían sin dejar una sola línea de rastro. Desde entonces, cada búsqueda de disponibilidad apunta la regla que la bloqueó y cada herramienta nueva se audita antes de darla por buena.
La privacidad se diseña
El problema de ataques revisaba la transcripción buscando el DNI o el teléfono del paciente. En lugar de pedirle al modelo que no los dijera, hicimos que nunca los viera, filtrando esos campos antes de que llegaran a su contexto. En las 142 llamadas revisadas hasta el sábado por la tarde no apareció ninguno. Aun así, el panel llegó a servir números de identidad durante un rato, hasta que lo detectamos y lo cortamos. La privacidad hay que revisarla en cada pieza, no solo en la que habla.
Este proyecto mejoró más borrando código que añadiéndolo.
El marcador, la noche y el domingo
El marcador del track era público y se movía cada pocos minutos. El primer checkpoint tuvo que retrasarse hasta las 13:00 del sábado porque la plataforma de Prosper se caía con todos los equipos intentando puntuar a la vez. Al final se lo llevó el primer equipo en llegar a 40 puntos, vortex. A esa hora nosotros ni siquiera estábamos en el podio.
Hora y cuarto después íbamos primeros con 64 puntos, 24 por delante de vortex. Duró poco. A las 16:45 habíamos caído al cuarto puesto con 71, a cinco del líder. Los problemas del 11 al 18 todavía no se habían abierto y ahí se iba a decidir todo.
Hacia las nueve se publicaron los últimos casos puntuables. Los equipos íbamos tan rápido que Prosper tuvo que improvisar. Lluc Santamaria, ingeniero de Prosper que supervisó el track, lo contaba así en LinkedIn (traducido del inglés).
Planeamos dieciocho problemas. El sábado por la noche estábamos escribiendo otros nuevos, porque los equipos se los habían acabado.
En cuanto salieron los problemas nuevos, todos los equipos solicitamos las llamadas a la vez. La plataforma de Prosper no podía puntuar a todos al mismo tiempo, así que mientras unos recibían sus llamadas otros esperaban turno, y el podio cambiaba cada pocos minutos. Ganaba quien antes recibía sus rondas y podía corregir y volver a lanzar. A las 21:36 estábamos cuartos con 151 puntos. Poco después llegamos a ir primeros con 169, a solo tres del máximo, pero fallamos una de las llamadas. refugia2 llegó antes a los 172 puntos, a las 22:05, y se llevó el premio del sábado por la noche. Ese mismo equipo acaba de publicar Rosario AI, su recepcionista de voz para clínicas.
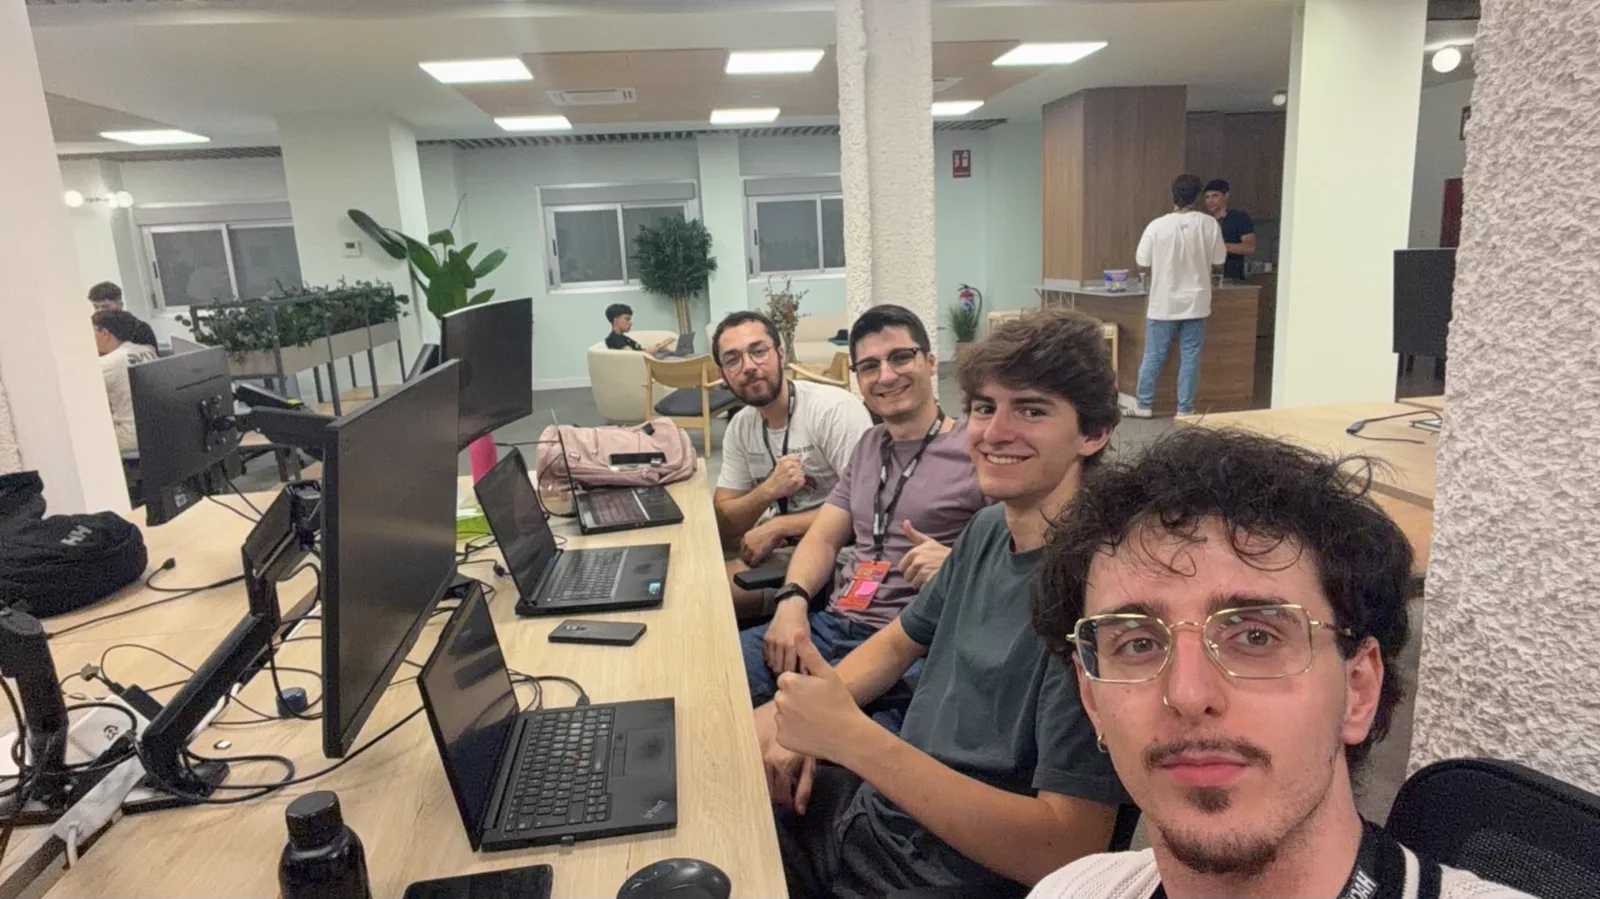
Esa noche la pasamos en las oficinas de Embat, junto a otros equipos. Mientras el marcador se cerraba seguían creciendo la cobertura de ausencias, las incidencias y el laboratorio, y había que preparar el vídeo y la presentación del día siguiente.
El domingo, con las entregas cerradas a las once, presentamos Pronto ante el jurado de Prosper en cinco minutos de pitch y cinco de preguntas. El premio del track, 1.000 euros, fue para vortex, por su sistema agéntico para las llamadas entrantes de una clínica. Joaquin Ferreiros, de ese equipo, lo resumía en LinkedIn con cifras que dan una idea del ritmo del fin de semana: más de 77.000 líneas de Python, 14 millones de tokens y un agente que superó todos los tests.
Por la tarde llegó una buena noticia, porque nos seleccionaron para ver la final. Los Exponential Fellows habían puntuado todos los proyectos. Los cinco primeros presentaron ante el jurado de fondos y el resto de las personas de ese corte, alrededor de un centenar, pudimos verla en directo. El gran premio fue para mafer AI. Fue el cierre de un fin de semana que había empezado con cinco personas reuniéndose por WhatsApp y un proyecto que parecía sencillo.
Una llamada no termina cuando el agente deja de hablar
Pronto acabó siendo mucho más que un agente que habla. Construimos una voz que intenta resolver la petición, una clínica que sabe a quién avisar cuando no puede, un panel para seguir lo que pasó y un laboratorio para ponerlo a prueba. Aprendimos a separar tres cosas que al principio parecían una: que la llamada sonara bien, que dejara la acción correcta y que pudiéramos demostrarlo.
Gracias a HackSpain por organizar un fin de semana así, a Prosper por un reto tan bien pensado y a todas las personas con las que coincidimos en la ETSIT.
Para ver cómo fue
- El vídeo resumen y las publicaciones de la comunidad, en la web oficial.
- La crónica oficial de HackSpain 2026, con los ganadores de cada track y las cifras del fin de semana, entre ellas 5.935 pushes, 1.658 pull requests y 93.700 millones de tokens procesados por herramientas de IA.
- La publicación de Joaquin Ferreiros, de vortex, el equipo que ganó el track de Prosper.
- La publicación de Lluc Santamaria, de Prosper, sobre cómo vivieron el track desde el otro lado del teléfono.
- El vídeo de Marta (@martaastl).